Le trunk-based development tient en une phrase : tout le monde intègre son travail sur une seule branche, plusieurs fois par jour. Ce qui le rend tenable tient en une autre : un pipeline de déploiement rapide, dont le verdict est définitif.
Les agents IA qui écrivent et committent du code ne changent pas ces règles. Ils les rendent plus nécessaires.
Trunk-based development ou feature branches : ce qui change vraiment
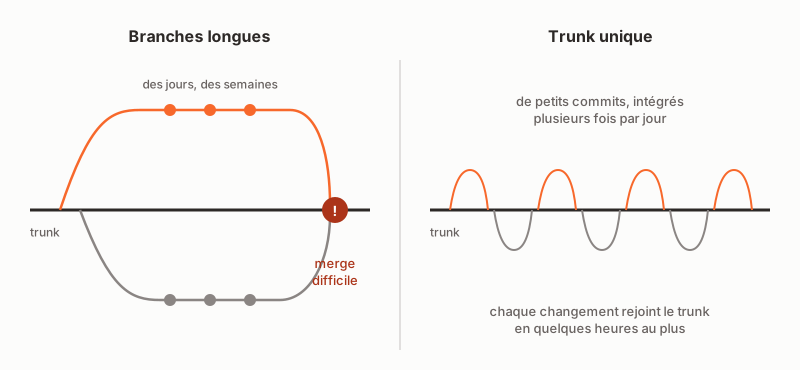
Le trunk, c’est la branche principale, qu’on appelle aussi main ou mainline. En trunk-based development, chaque développeur y merge son travail au moins une fois par jour, parfois plusieurs. S’il crée des branches, elles durent en général quelques heures au plus, et l’équipe n’en a pas plus de trois actives à la fois. Une feature branch, elle, porte des jours ou des semaines de travail (DORA, « Trunk-based development »).
MinimumCD.org, un site consacré aux pratiques de base de la livraison continue, en fait une condition minimale de l’intégration continue : le travail s’intègre au trunk au moins une fois par jour.
Dave Farley, coauteur avec Jez Humble du livre Continuous Delivery (2010), va plus loin. Sa stratégie de branches idéale tient en deux mots : « ne pas brancher ». Si des branches existent, elles doivent être minuscules, peu nombreuses et courtes, mergées au moins une fois par jour. Quand une équipe travaille bien, elle merge toutes les 10 ou 15 minutes (Continuous Delivery Pipelines, 2021, p. 44).
La différence ne porte donc pas sur l’outil. Elle porte sur le temps pendant lequel un changement vit à l’écart des autres.
Ce qui distingue les deux pratiques, c'est la durée pendant laquelle un changement reste à l'écart du trunk.
Pourquoi les branches longues coûtent plus cher qu’elles n’en ont l’air
Une branche longue retarde l’intégration. Pendant qu’elle vit, le trunk avance sans elle, et elle avance sans le trunk. Les deux s’écartent. Le jour du merge, il faut réconcilier tout ce qui a changé des deux côtés.
Humble et Farley décrivent la promesse et ce qu’elle devient. La promesse : aller plus vite en faisant de gros changements sur une branche, puis tout rebrancher à la fin. En pratique, c’est le rebranchement qui devient la partie difficile, et plus le changement est gros, plus le merge final est dur. Ils en tirent une formule : plus la raison de créer une branche paraît forte, moins il faut le faire (Continuous Delivery, 2010, p. 349). Ils notent aussi qu’une application dont le travail se fait sur des branches n’est pas intégrée en continu (p. 347).
DORA, le programme de recherche de Google Cloud sur le développement et la mise en production des logiciels, relie le trunk-based development à de meilleures performances de livraison et d’exploitation, d’après ses données de 2016 et 2017. Le même programme recommande de ne pas avoir de code freeze ni de phase d’intégration (« Trunk-based development »).
Une branche courte, c’est aussi un petit changement.
Le pipeline de déploiement (CI/CD) : une étape de commit en moins de cinq minutes, un seul artefact
Intégrer plusieurs fois par jour ne tient que si chaque intégration est vérifiée vite. C’est le rôle du pipeline de déploiement.
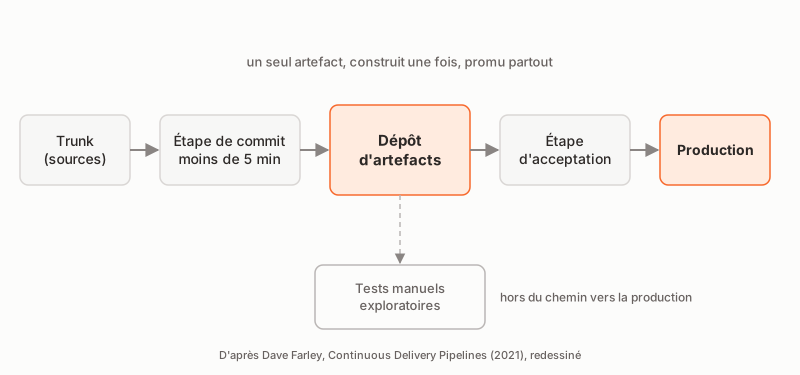
L’étape de commit compile le code, lance les tests rapides, et rend son verdict au développeur en moins de 5 minutes (Continuous Delivery Pipelines, p. 52 et 121). Si elle passe, elle produit le release candidate : l’unité exacte qui finira en production, s’il va jusque-là (p. 58).
Ce candidat est construit une seule fois. Humble et Farley expliquent pourquoi : recompiler à chaque étape, c’est risquer de mettre en production autre chose que ce qui a été testé (Continuous Delivery, p. 113 et 114).
Le candidat est rangé dans un dépôt d’artefacts. Farley l’appelle la version de vérité : ce qui s’y trouve, ce sont les octets exacts qu’on a l’intention de déployer en production. La configuration propre à chaque environnement en est séparée, et aucune version n’est construite pour un environnement particulier (Continuous Delivery Pipelines, p. 60).
L’étape d’acceptation prend ce candidat et suit toujours les mêmes quatre pas : configurer l’environnement, déployer le candidat, vérifier qu’il démarre, lancer les tests d’acceptation (p. 65). Les tests manuels, eux, sont exploratoires. Ils ne portent que sur des candidats qui ont déjà passé l’acceptation, et ne servent pas à vérifier la non-régression (p. 73 et 74).
MinimumCD résume ces règles. Le pipeline est le seul moyen de déployer dans n’importe quel environnement. L’artefact est immuable : aucune modification humaine après le commit. Le pipeline décide si un changement peut partir en production, et son verdict est définitif.
Un seul artefact, construit une fois, promu jusqu'en production. Les tests exploratoires restent hors du chemin.
Voici le principe, écrit en pseudo-configuration, sans syntaxe d’outil :
# Pseudo-configuration écrite pour cet article : le principe, pas un outil.
pipeline:
  déclencheur: chaque commit sur le trunk

  étape de commit:
    durée visée: moins de 5 minutes
    faire:
      - compiler
      - lancer les tests rapides
      - construire le candidat, une seule fois
      - ranger le candidat dans le dépôt d'artefacts
    en cas d'échec: arrêter la ligne

  étape d'acceptation:
    exclusive: toute l'étape, du premier pas au dernier
    candidat: le plus récent qui a passé l'étape de commit
    faire:
      - configurer l'environnement
      - déployer le candidat
      - vérifier qu'il répond
      - lancer les tests d'acceptation
      - arrêter l'environnement
    en cas d'échec: arrêter la ligne

  production:
    candidat: celui qui a passé l'acceptation
    passage: décidé par une personne (livraison continue)
             ou automatique (déploiement continu)
Pipeline rouge : tout s’arrête, on corrige ou on annule
Un pipeline rouge veut dire une chose : le trunk n’est plus prêt pour la production. Farley en fait la priorité de l’équipe, qui doit garder libre le chemin vers la production (Continuous Delivery Pipelines, p. 57). MinimumCD le dit plus sèchement : quand le pipeline principal est rouge, tout travail sur les fonctionnalités s’arrête.
Humble et Farley appellent cela arrêter la ligne : si une partie du pipeline échoue, on s’arrête (Continuous Delivery, p. 119).
Ensuite, deux options seulement. Corriger en une dizaine de minutes, ou annuler le changement (Continuous Delivery Pipelines, p. 56). Et si l’auteur du changement est parti, l’équipe l’annule à sa place (p. 57).
L’annulation est elle-même un commit. Elle traverse le pipeline comme les autres, et l’historique garde la trace de ce qui s’est passé.
Quand des agents IA committent : plus de commits, mêmes règles
Le rapport 2024 de DORA, tiré d’une enquête auprès de professionnels de la tech, a mesuré ce que ses auteurs n’attendaient pas. Quand l’adoption de l’IA augmente de 25 %, le débit de livraison, c’est-à-dire la quantité de changements mis en production, baisse d’environ 1,5 %. La stabilité, autrement dit la part de ces changements qui ne posent pas de problème une fois en ligne, baisse d’environ 7,2 % (Accelerate State of DevOps 2024, p. 39 et 40). Ce sont des estimations tirées d’une enquête : une corrélation, pas une preuve de cause.
Les auteurs avancent une hypothèse. L’IA permet de produire beaucoup plus de code dans le même temps. Il est donc possible, et même probable selon eux, que la taille des changements augmente. Or leurs données montrent depuis des années que les gros changements sont plus lents et plus souvent source d’instabilité (p. 40).
Si l’hypothèse est juste, la réponse n’est pas un nouvel outil. C’est la discipline des petits lots, appliquée aux agents comme aux humains. DORA décrit d’ailleurs le travail en petits lots comme un filet de sécurité pour l’adoption de l’IA (« Working in small batches »).
MinimumCD en tire des règles concrètes pour les agents (« Agentic CD ») :
un changement écrit par un agent doit atteindre au moins le niveau de qualité exigé d’un changement écrit par un humain ;
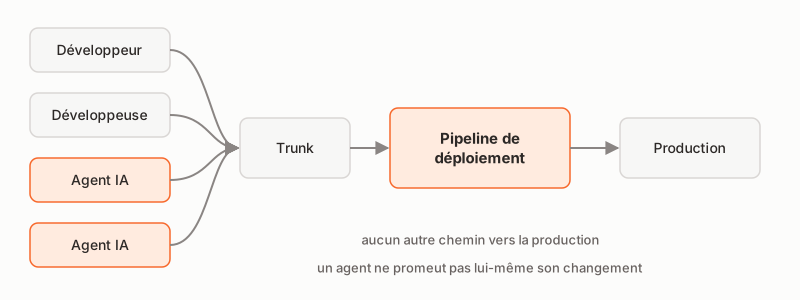
il est déployé par le même pipeline que tout autre changement ;
un agent qui écrit un changement ne doit pas pouvoir le promouvoir en production ;
tant que le pipeline est rouge, les agents ne produisent que des changements qui le remettent au vert.
L’agent n’a donc pas plus de droits qu’un développeur. Le pipeline reste le seul chemin vers la production.
Reste la code review. Bryan Finster, développeur qui a aidé Walmart à étendre la livraison continue à ses équipes et qui maintient aujourd’hui MinimumCD, défend dans « AI broke your code review, here’s how… » l’idée de réserver le jugement humain à ce qui en a besoin : le comportement défini en équipe avant le code, les scénarios devenus tests d’acceptation, le savoir propre à l’équipe et la conformité. Dans une publication LinkedIn du 24 septembre 2026, il décrit l’une de ses meilleures équipes. Aucune code review ne bloquait la livraison : « Our pipelines reviewed the code » (nos pipelines faisaient la revue du code).
Humains ou agents, chaque changement suit le même chemin. Aucun ne contourne le pipeline.
Un environnement de recette partagé : un candidat à la fois, le plus récent d’abord
Plus de commits veut dire plus de candidats. Que se passe-t-il quand l’étape d’acceptation est occupée et que de nouveaux candidats arrivent ?
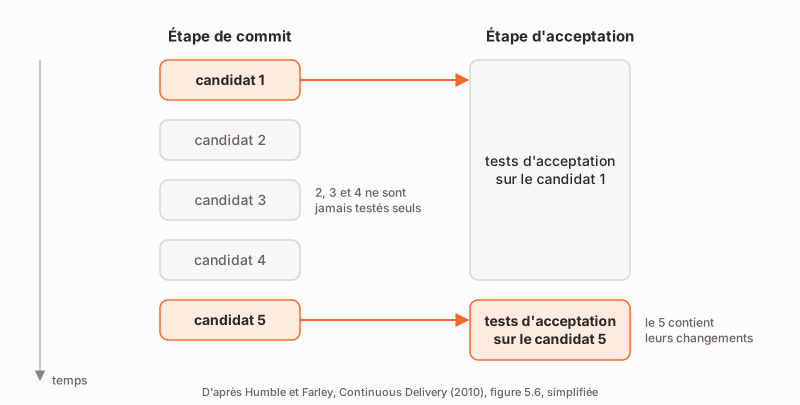
Humble et Farley répondent par un exemple (Continuous Delivery, p. 118 et 119, figure 5.6). Les tests d’acceptation tournent sur le candidat 1. Pendant ce temps, d’autres changements arrivent et passent l’étape de commit. Le pipeline ne lance pas une seconde exécution des tests d’acceptation, puisqu’ils tournent déjà. Il ne range pas non plus les candidats en file d’attente : s’il les testait tous, il prendrait de plus en plus de retard sur ce que font les développeurs. Quand l’acceptation se libère, elle prend le candidat le plus récent, ici le 5. Le 2 n’est jamais testé seul. Sur un trunk unique, le candidat 5 contient ses changements.
Farley décrit le même fonctionnement onze ans plus tard, sur une plateforme d’échange financier dont il a dirigé le développement. L’acceptation durait moins de 40 minutes, et l’étape de commit produisait pendant ce temps une dizaine de candidats. Quand l’étape d’acceptation se libérait, on déployait le candidat le plus récent. Les changements étaient ainsi regroupés, et l’acceptation n’accumulait pas un retard qu’elle n’aurait jamais rattrapé (Continuous Delivery Pipelines, p. 131).
Quand l'acceptation se libère, elle prend le candidat le plus récent. D'après Humble et Farley, 2010, figure 5.6, simplifiée.
Seconde règle : l’étape d’acceptation est exclusive dans son ensemble. Ses quatre pas se suivent pour un même candidat (Continuous Delivery Pipelines, p. 65). Humble et Farley décrivent une instance du système créée propre au début de l’exécution des tests d’acceptation, utilisée par tous ces tests, puis arrêtée à la fin (Continuous Delivery, p. 219 et 220).
Si l’on réserve seulement le déploiement, et pas la séquence entière, un autre candidat peut être déployé entre le déploiement et les tests du premier. Les tests valident alors un autre logiciel que celui dont ils portent le nom.
Le travail inachevé sur la branche principale : connecter en dernier, ou un feature toggle
Intégrer plusieurs fois par jour veut dire committer du code qui n’est pas fini. Humble et Farley donnent trois façons de garder le trunk prêt pour la production malgré cela (Continuous Delivery, p. 347 à 349) :
cacher la nouvelle fonctionnalité tant qu’elle n’est pas finie : le code est déployé, mais rien n’y mène ;
faire chaque changement par petits incréments, chacun prêt à partir en production ;
pour un changement de grande ampleur, la technique dite Branch by Abstraction (branchement par abstraction) : une couche d’abstraction devant la partie à remplacer, la nouvelle implémentation construite à côté de l’ancienne, puis l’ancienne retirée.
Le feature toggle vient après ces techniques, quand aucune ne suffit. Nous détaillons quand il se justifie, et les erreurs qui le rendent dangereux, dans l’article sur les feature toggles.
Comment nous travaillons
Nous travaillons sur un trunk unique, avec un pipeline qui rend son verdict sur chaque commit. L’IA fait partie de nos outils, à l’intérieur d’une approche où chaque modification est vérifiée par des tests automatisés.
Pour le développement d’un logiciel sur mesure, nous travaillons pour un budget fixe, facturé chaque fin de mois pour le travail réalisé. Votre application est utilisable en un mois, en quelques fonctionnalités essentielles : vos utilisateurs s’en servent immédiatement, et c’est leur usage qui définit les fonctionnalités suivantes à développer. Une fois recettée et mise en ligne, chaque fonctionnalité est jugée sur la réaction de vos utilisateurs, et nous décidons aussitôt avec vous des suivantes, tant que vous le souhaitez. Une application n’est jamais finie.
Et pour que ce qui fonctionnait le mois dernier fonctionne encore ce mois-ci, nous appliquons une garantie zéro régression : chaque régression est corrigée et couverte par un test automatisé, pour qu’elle ne revienne pas, et sans surcoût.
Pour aller plus loin
Dans notre guide, vous trouverez les questions à poser avant de signer un devis pour le développement de votre outil sur mesure.
Vous avez un logiciel à faire développer, et vous voulez qu’il soit construit ainsi ? On en parle ?
Sources
Les citations traduites de l’anglais le sont par nous.
MinimumCD.org, liste des pratiques minimales de la livraison continue et de l’intégration continue : https://minimumcd.org/
Livraison continue (continuous delivery) et déploiement continu (continuous deployment) ne diffèrent que d'un geste. Pourquoi un petit changement fréquent est moins risqué qu'un gros, sources à l'appui.
Feature flag, c'est quoi ? Quatre types de toggles, ce qu'il faut essayer avant d'en ajouter un, et sept anti-patterns qui font tourner du code jamais testé.