Un feature flag, ou feature toggle, est un interrupteur dans le code. Selon sa valeur, l’application suit un chemin ou un autre. DORA, le programme de recherche de Google Cloud sur le développement et la mise en production des logiciels, le définit comme une instruction conditionnelle fondée sur des réglages de configuration (« Working in small batches »).
Ajouter un toggle est simple. Mais quand on les gère mal, on finit par faire tourner en production des combinaisons de réglages que personne n’a testées. Pete Hodgson, consultant indépendant en livraison logicielle, prévient dès l’introduction de son article sur le sujet : les toggles introduisent de la complexité, et il faut chercher à limiter leur nombre (« Feature Toggles (aka Feature Flags) », 2017).
Feature flag, c’est quoi : quatre types, quatre durées de vie
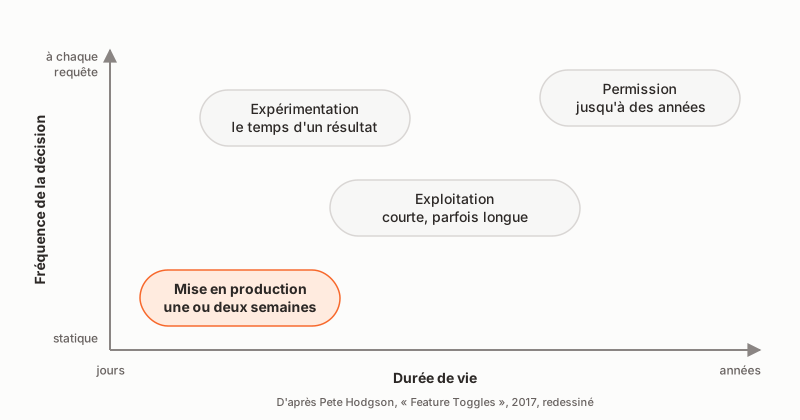
Hodgson classe les toggles en quatre catégories, selon deux critères : combien de temps ils vivent, et à quelle fréquence leur décision change.
Les toggles de mise en production permettent de déployer en production du code inachevé, qui reste inactif. Ils ne devraient en général pas rester beaucoup plus d’une ou deux semaines, et leur décision change rarement.
Les toggles d’expérimentation servent aux tests A/B. Ils restent en place, avec la même configuration, le temps d’obtenir des résultats statistiquement significatifs. Leur décision est très dynamique.
Les toggles d’exploitation pilotent le comportement du système en production, par exemple pour couper une fonction pendant un incident. La plupart vivent peu ; certains, les kill switches, peuvent rester longtemps.
Les toggles de permission réservent une fonctionnalité à certains utilisateurs. Ils peuvent vivre des années, et leur décision se prend toujours à chaque requête.
Savoir à quelle catégorie appartient un toggle dit combien de temps il a le droit de vivre. Hodgson ajoute que les équipes avisées traitent leurs toggles comme un stock qui a un coût de détention, et cherchent à garder ce stock aussi bas que possible.
Quatre catégories, quatre durées de vie. D'après Pete Hodgson, 2017, redessiné.
Avant un feature flag : connecter en dernier, ou branchement par abstraction
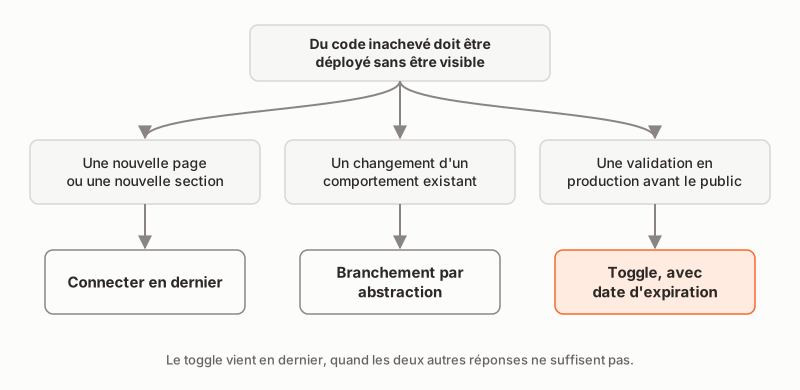
Martin Fowler, l’un des signataires du Manifeste agile et directeur scientifique de Thoughtworks, en fait une règle : les toggles de mise en production doivent être le dernier choix pour faire entrer une fonctionnalité en production. Le premier choix est de la découper pour en introduire les morceaux sans risque (« Feature Flag », 2010).
Première technique : connecter en dernier. On construit tout ce qui se trouve derrière l’interface, on l’intègre au trunk, on le déploie, mais rien n’y mène. Le dernier commit ajoute le point d’entrée, le lien ou le bouton, et rend la fonctionnalité visible. Jez Humble et Dave Farley, les deux auteurs du livre Continuous Delivery, racontent une nouvelle interface développée sous une adresse vers laquelle aucun lien ne pointait, puis reliée morceau par morceau à la navigation existante. L’application a fonctionné tout du long (Continuous Delivery, 2010, p. 348). Fowler appelle ce dernier morceau la keystone interface (« Keystone Interface », 2020).
Pour modifier un comportement qui existe déjà, on emploie la seconde technique, dite Branch by Abstraction (branchement par abstraction). On place une couche d’abstraction devant la partie à changer, on construit la nouvelle implémentation à côté de l’ancienne, puis on retire l’ancienne, et parfois l’abstraction elle-même (Continuous Delivery, p. 349).
Reste le cas où une personne doit voir la fonctionnalité en production avant tout le monde, pour la recetter. Là, un toggle se justifie. Même alors, Fowler conseille qu’il ne porte que sur l’interface, pour ne pas disperser les toggle points dans tout le code.
Le toggle arrive en dernier, quand les deux autres techniques ne suffisent pas.
« Allumé en recette, éteint en production. » Le code ressemble à ceci :
// Anti-pattern : la décision dépend du nom de l'environnement.
if (process.env.APP_ENV === "staging") {
  showInvoiceExport();
}
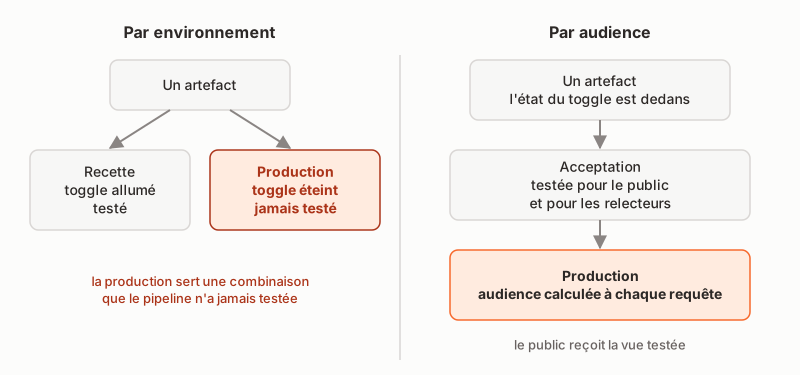
Le problème tient en une phrase : la production exécute une combinaison que le pipeline n’a jamais testée. Les tests d’acceptation ont tourné avec l’interrupteur allumé ; la production tourne avec l’interrupteur éteint.
MinimumCD.org, un site consacré aux pratiques de base de la livraison continue, décrit la conséquence. Les chemins de code réservés à la production ne sont jamais exécutés par la suite de tests, et si la production fait tourner une autre logique, la validation en recette est incomplète par construction (« Hard-Coded Environment Assumptions »). Hodgson va dans le même sens : toute surcharge propre à un environnement va à l’encontre de l’idéal de la livraison continue, qui cherche à garder les unités déployables et leur configuration aussi indépendantes que possible de l’environnement. Humble et Farley posaient déjà le principe : déployer les mêmes binaires partout, pour que ce qu’on met en production soit ce qu’on a testé (Continuous Delivery, p. 42).
À la place : l’état du toggle fait partie de la configuration de l’application, livrée avec l’artefact, identique dans tous les environnements. Ce qui varie, c’est l’audience, calculée à chaque requête. Nous y revenons plus bas.
Par environnement, la production sert une configuration jamais testée. Par audience, le public reçoit la vue que le pipeline a testée.
2. Le chemin éteint jamais testé
Pour gagner du temps, on teste « tout allumé ». C’est la configuration de demain. Ce n’est pas celle que le public reçoit aujourd’hui.
Hodgson est net. Le plus important est de tester la configuration de toggles qui sera active en production. Il est sage de tester aussi la configuration de repli. Et beaucoup d’équipes ajoutent des tests avec tous les toggles allumés, pour éviter les régressions surprises à la prochaine mise en production.
À la place : au moins deux configurations testées, celle de la production et celle où tout est allumé.
3. Le toggle qui dure
Un toggle de mise en production sert à cacher un travail en cours. Selon Hodgson, il ne devrait en général pas rester beaucoup plus d’une ou deux semaines. Un toggle qui vit des mois ne cache plus un travail en cours : il entretient deux versions du logiciel, et chacune doit être testée.
À la place : une date d’expiration dès la création, et un test qui échoue quand elle est dépassée.
4. La dette de toggles
Chaque toggle double le nombre de combinaisons possibles. Deux toggles en font quatre ; dix en font plus de mille.
Hodgson décrit ce que font les équipes qui gardent ce stock bas. Elles ajoutent une tâche de retrait au backlog dès qu’un toggle est créé. Elles posent une date d’expiration sur chaque toggle. Certaines écrivent des « bombes à retardement », qui font échouer un test, voire refusent de démarrer l’application, quand la date est passée. D’autres fixent un plafond au nombre de toggles autorisés à la fois. Humble et Farley donnaient déjà le conseil : ne pas garder trop d’options, et les élaguer avec soin une fois qu’elles ont servi (Continuous Delivery, p. 348).
5. Le toggle à la place de « connecter en dernier »
Une nouvelle page, une nouvelle section, un nouveau rapport : rien ne les montre tant qu’aucun lien n’y mène. Leur ajouter un toggle, c’est payer la complexité d’un interrupteur pour obtenir ce que l’absence de lien donnait déjà.
Fowler le formule ainsi : n’employer de toggles de mise en production que si l’on ne peut ni livrer par petits morceaux, ni utiliser une keystone interface (« Feature Flag »).
6. Le toggle recyclé
En 2012, une société de courtage américaine a perdu plus de 460 millions de dollars en 45 minutes environ. L’ordonnance de la SEC, l’autorité américaine des marchés financiers, décrit l’enchaînement (ordonnance n° 34-70694, 2013, § 13 à 17).
Le nouveau code réutilisait un flag qui servait autrefois à activer une ancienne fonctionnalité. Cette fonctionnalité était abandonnée depuis des années, mais son code était toujours présent et pouvait encore être appelé. Lors du déploiement, l’un des huit serveurs n’a pas reçu le nouveau code. Sur ce serveur, les ordres qui portaient le flag recyclé ont activé l’ancien code, qui ne fonctionnait plus correctement.
Deux erreurs se sont ajoutées l’une à l’autre : un flag qui change de sens, et un code mort jamais retiré. Farley cite le même cas pour une troisième, le déploiement manuel, serveur par serveur (Continuous Delivery Pipelines, 2021, p. 112 et 113). Hodgson le présente comme une mise en garde sur ce qui arrive quand on gère mal ses toggles.
À la place : un toggle porte un seul sens, pour une seule fonctionnalité, et disparaît avec elle. Un nouveau besoin reçoit un nouveau toggle, sous un nouveau nom. Le code que le toggle remplace est supprimé en même temps que lui.
7. Masquer côté navigateur
Le toggle est évalué dans le navigateur. La nouvelle section est dans la page, mais cachée par une règle CSS ou par l’attribut hidden. Le contenu est quand même envoyé à chaque visiteur.
La spécification HTML le rappelle. L’attribut hidden est en général mis en œuvre par CSS, et peut donc être annulé par CSS. Les éléments cachés restent actifs : leurs scripts s’exécutent, leurs formulaires s’envoient (WHATWG, HTML Living Standard, « The hidden attribute »). N’importe quel visiteur peut afficher ce qui était caché depuis les outils de développement de son navigateur.
À la place : décider côté serveur. Un visiteur qui n’est pas dans l’audience ne reçoit tout simplement pas le contenu.
L’état dans l’artefact, l’audience par requête
Deux questions se cachent derrière chaque toggle. Dans quel état est-il ? Qui voit la fonctionnalité ? Les mélanger, c’est l’anti-pattern 1.
L’état fait partie de la configuration de l’application. MinimumCD range les feature flags dans la configuration interne à l’application, qui ne varie pas selon l’environnement. Cette configuration se déploie avec l’artefact immuable et ne change plus une fois l’artefact construit (« Application Configuration »). Le même artefact, avec le même état, passe donc l’acceptation puis part en production.
L’audience se décide à chaque requête. Hodgson recommande de séparer le toggle point, l’endroit du code où la décision s’applique, de la logique qui prend cette décision. Il signale aussi le risque des surcharges par cookie, paramètre d’URL ou en-tête HTTP : un utilisateur curieux ou malveillant peut alors modifier lui-même l’état du toggle. L’audience se calcule donc à partir d’une identité vérifiée côté serveur, jamais d’un paramètre que le navigateur peut forger.
Voici un registre de toggles typé, écrit pour cet article :
Un toggle in-progress n’est visible par personne. Un toggle in-review n’est visible que par les relecteurs. Il n’existe pas d’état « visible par tous » : rendre la fonctionnalité visible par tous, c’est retirer le toggle.
Tester la configuration de production, et le repli
Deux tests suffisent à couvrir l’anti-pattern 2. Le premier rend la page comme la reçoit le public, avec la configuration réellement livrée. Le second la rend comme la reçoit un relecteur, toggle allumé. Ils sont écrits ici dans la syntaxe commune à Jest et Vitest ; renderInvoicesPage est une fonction fictive qui rend la page côté serveur.
test("le public reçoit la page sans l'export des factures", async () => {
  const page = await renderInvoicesPage({ viewer: null });
  expect(page.text).not.toContain("Exporter les factures");
});

test("un relecteur reçoit la page avec l'export des factures", async () => {
  const page = await renderInvoicesPage({ viewer: { roles: ["reviewer"] } });
  expect(page.text).toContain("Exporter les factures");
});
Le premier test protège ce que le public voit aujourd’hui. Le second vérifie que la fonctionnalité fonctionne avant qu’on la rende visible par tous.
Plafond, date d’expiration et test qui échoue : retirer un feature flag
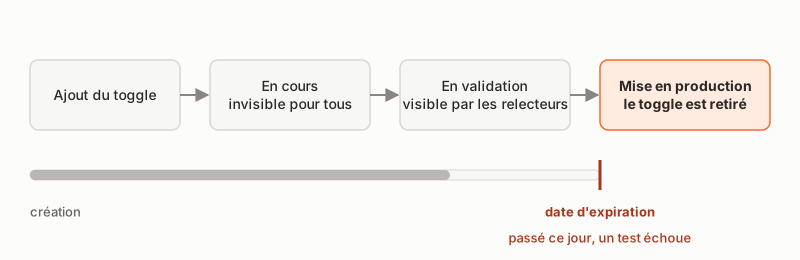
Un toggle de mise en production suit trois étapes. Il naît avec la fonctionnalité, invisible pour tous. Il passe en validation, visible par les relecteurs. Puis le commit de mise en production le retire, avec l’ancien chemin s’il y en avait un : la condition disparaît, et le nouveau code devient le seul chemin.
Un toggle de mise en production a une fin prévue dès sa création. Passé sa date, un test échoue.
Pour que cette fin arrive, deux tests font la « bombe à retardement » décrite par Hodgson :
test("aucun toggle de mise en production n'a dépassé sa date d'expiration", () => {
  const today = new Date().toISOString().slice(0, 10);
  const expired = releaseToggles
    .filter((toggle) => toggle.expiresOn < today)
    .map((toggle) => toggle.name);
  expect(expired).toEqual([]);
});

test("le nombre de toggles ne dépasse pas le plafond", () => {
  expect(releaseToggles.length).toBeLessThanOrEqual(MAX_RELEASE_TOGGLES);
});
Le premier test échoue le jour où une date est dépassée, et le pipeline passe au rouge. L’équipe a alors deux options : mettre la fonctionnalité en production et retirer le toggle, ou retirer la fonctionnalité. Le second test empêche d’ouvrir un nouveau toggle tant que le plafond est atteint.
Comment nous travaillons
Pour nos clients, un toggle sert à recetter une fonctionnalité en production avant qu’elle soit visible par tous. Nous le décrivons ainsi dans notre approche : « Dès que la fonctionnalité est recettée, nous rendons la nouvelle version visible. Le code est déjà déployé via notre pipeline de déploiement automatisé et attend ce feu vert pour être activé en production. Si vous préférez ne pas déléguer la recette, vous testez et approuvez vous-même chaque fonctionnalité. »
Pour le développement d’un logiciel sur mesure, nous travaillons pour un budget fixe, facturé chaque fin de mois pour le travail réalisé. Votre application est utilisable en un mois, en quelques fonctionnalités essentielles : vos utilisateurs s’en servent immédiatement, et c’est leur usage qui définit les fonctionnalités suivantes à développer. Une fois recettée et rendue visible, chaque fonctionnalité est jugée sur la réaction de vos utilisateurs, et nous décidons aussitôt avec vous des suivantes, tant que vous le souhaitez. Une application n’est jamais finie.
Et pour que ce qui fonctionnait le mois dernier fonctionne encore ce mois-ci, nous appliquons une garantie zéro régression : chaque régression est corrigée et couverte par un test automatisé, pour qu’elle ne revienne pas, et sans surcoût.
Pour aller plus loin
Dans notre guide, vous trouverez les questions à poser avant de signer un devis pour le développement de votre outil sur mesure.
Vous avez un logiciel à faire développer, et vous voulez qu’il soit construit ainsi ? On en parle ?
Sources
Les citations traduites de l’anglais le sont par nous.
Livraison continue (continuous delivery) et déploiement continu (continuous deployment) ne diffèrent que d'un geste. Pourquoi un petit changement fréquent est moins risqué qu'un gros, sources à l'appui.
Approche prédictive ou adaptative ? La vraie différence n'est pas entre le cycle en V et l'agilité, mais entre prédire et s'adapter. Ce que cela change pour un logiciel.