Continuous Delivery, Continuous Deployment: An Definitionen mangelt es nicht. Sie sagen, was die beiden Praktiken sind. Selten sagen sie, warum sie funktionieren, also warum eine kleine Änderung, die oft in Produktion geht, weniger riskant ist als eine große, die selten in Produktion geht.
Dieser Artikel geht von dieser Frage aus und gibt wieder, was die zitierten Quellen 2026 darauf antworten. Er richtet sich an technische Verantwortliche und Entwickler, die den Mechanismus verstehen wollen, nicht nur die Begriffe.
Continuous Delivery vs. Continuous Deployment: der Unterschied in einem Satz
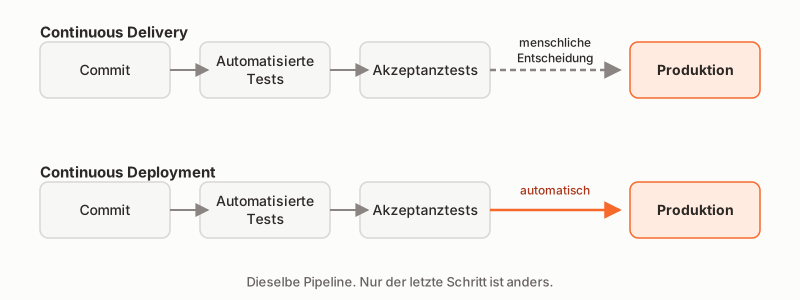
Bei Continuous Delivery ist die Software jederzeit bereit, in Produktion zu gehen. Bei Continuous Deployment geht sie automatisch dorthin, sobald die Pipeline grün ist.
In beiden Fällen durchläuft jede Änderung dieselbe Deployment-Pipeline: Build, automatisierte Tests, Prüfungen. Jez Humble und Dave Farley, die Autoren des Buchs, das Continuous Delivery definiert hat, beschreiben Continuous Deployment als dieselbe Pipeline, deren letzter Schritt, das Deployment in Produktion, automatisiert wird (Continuous Delivery, 2010, S. 266). An anderer Stelle bringt Farley es auf eine Formel: Continuous Deployment heißt, „die Entscheidung über das Release zu automatisieren“.
Bei Continuous Delivery trifft diese Entscheidung ein Mensch. Die Software ist bereit; jemand wählt den Zeitpunkt. Die beiden Autoren geben dazu eine Regel mit: Auch wenn es gute Gründe gibt, nicht jede Änderung zu releasen, sollte man so arbeiten, als würde man es tun (S. 267).
Eine Pipeline. Nur der letzte Schritt ändert sich: eine menschliche Entscheidung bei Continuous Delivery, automatisch bei Continuous Deployment.
Der Rest des Artikels gilt für beide Praktiken. Was sie gemeinsam haben, zählt mehr als ihr Unterschied: kleine, häufige Änderungen.
Warum eine kleine Änderung weniger riskant ist als eine große
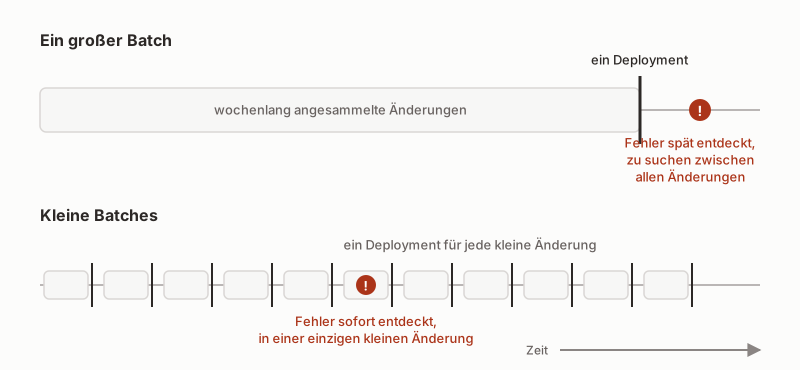
Eine kleine Änderung betrifft wenig. Schlägt direkt danach ein Test fehl, liegt die Ursache in dieser Änderung. Der Entwickler, der sie gerade geschrieben hat, hat sie noch im Kopf. Er behebt den Fehler sofort oder macht seinen Commit rückgängig.
Eine große Änderung betrifft viel. Taucht ein Fehler auf, versteckt er sich zwischen all den Anpassungen, die sie enthält. Die Ursache zu suchen kostet Zeit. Alles zurückzunehmen entfernt auch das, was funktioniert hat.
Farley macht daraus einen Grundsatz von Continuous Delivery. Kleine, einfache, häufige Änderungen sind weniger riskant als große, komplizierte und seltene. Weil sie einfacher sind, lassen sie sich leichter verstehen und leichter rückgängig machen. Kleinere Schritte bedeuten kleinere Fehler und schnelleres Feedback (Continuous Delivery Pipelines, 2021, S. 54).
Humble und Farley wenden dieselbe Überlegung auf Releases an. Je häufiger man released, desto geringer ist das Risiko jedes einzelnen Releases, weil sich zwischen zwei Releases weniger ändert. Wer jede Änderung released, begrenzt das Risiko auf das Risiko dieser einen Änderung (Continuous Delivery, S. 267).
Im selben Zeitraum versteckt ein großer Batch den Fehler zwischen vielen Änderungen; ein kleiner Batch zeigt ihn sofort.
Der umgekehrte Reflex ist verbreitet: mehr Kontrollen einbauen. Eine Freigabe durch ein Gremium, eine Unterschrift mehr vor jedem Release. Farley beschreibt, was dann passiert. Releases werden seltener, also größer und komplexer, also fehleranfälliger (Continuous Delivery Pipelines, S. 110). Er zitiert den Bericht von DORA, dem Forschungsprogramm von Google Cloud dazu, wie Software entwickelt und in Produktion gebracht wird: Freigaben durch eine externe Stelle korrelieren negativ mit Durchlaufzeit, Deployment-Häufigkeit und Wiederherstellungszeit und korrelieren nicht mit der Change Failure Rate (S. 111).
Funktion für Funktion ausliefern: was sich für die Nutzer ändert
Eine kleine Änderung ist keine Funktion. Eine Funktion entsteht aus mehreren Commits, die jeweils getestet und bereit für die Produktion sind. Farley formuliert es so: Funktionen aus mehreren Commits aufbauen, damit sich das Produkt schrittweise weiterentwickelt, mit häufigem Feedback der Nutzer. Und wenn eine Funktion zu groß ist, sie in kleinere Teile zerlegen (Continuous Delivery Pipelines, S. 55).
Für ihn ist eine Änderung erst fertig, wenn sie bei ihren Nutzern angekommen ist (S. 6). Hier zahlen sich kleine Schritte aus. Jede Funktion erreicht schnell die Menschen, die sie nutzen, und ihre Nutzung zeigt, ob sie sinnvoll war.
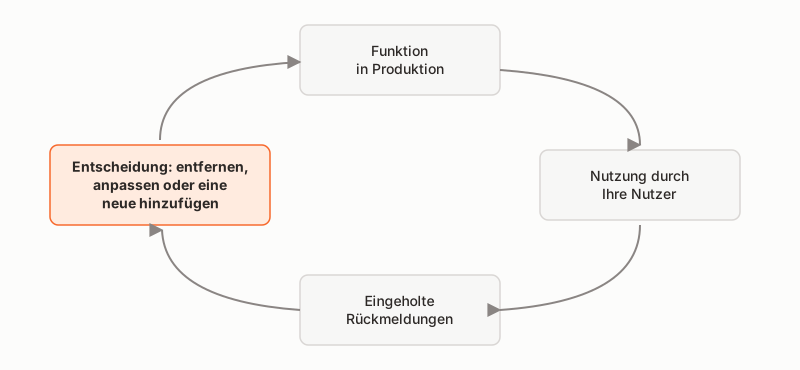
Das ist der Kreislauf, den wir in unserem Ansatz beschreiben: „Sobald eine Funktion live ist, sagen uns die Rückmeldungen, die wir bei Ihren Nutzern einholen, was als Nächstes zu tun ist: sie entfernen, sie anpassen oder eine neue hinzufügen.“
Jede Funktion in Produktion bringt Rückmeldungen, und diese Rückmeldungen entscheiden, wie es weitergeht.
Bleibt die Frage, was man zerlegt, und in welcher Reihenfolge. Wir zerlegen nicht nach geschätzter Dauer. Wir stellen eine einzige Frage: Was ist jetzt das Nützlichste? Eine Zeitschätzung bleibt eine Vermutung; warum, erklären wir im Artikel über Softwareprojekte, die ihr Budget überschreiten.
Deployen ist nicht Releasen
Eine Funktion, die in mehreren Commits entsteht, durchläuft Zwischenstände. Ein halb fertiger Bildschirm darf bei den Nutzern nicht auftauchen. Muss man also warten, bis sie fertig ist, um zu deployen? Nein. Es genügt, zwei Vorgänge zu trennen.
Deployen ist der technische Vorgang, eine neue Version der Software in eine Umgebung zu kopieren und zu starten, sodass sie betriebsbereit ist;
Releasen heißt, eine neue Funktion für einen Nutzer verfügbar zu machen.
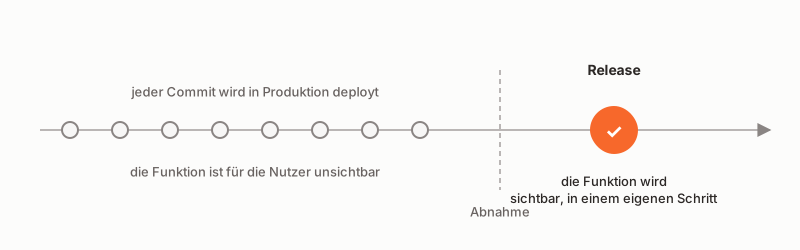
Im Alltag sagt man oft für beides „in Produktion bringen“. Bei DEVEDANOS verwenden wir „Release“ nur für den zweiten Vorgang. Wir deployen den Code kontinuierlich und releasen die Funktion, sobald sie abgenommen ist.
Farley stellt klar, dass man Änderungen deployen kann, die noch nicht zur Nutzung bereit sind. Daraus leitet er eine Arbeitsregel ab: Jeder Commit muss sicher, getestet und bereit für das Deployment in Produktion sein, auch wenn die Funktion, zu der er beiträgt, noch nicht fertig ist (Continuous Delivery Pipelines, S. 55).
Wie bleibt deployter Code unsichtbar? Humble und Farley beschreiben eine Lösung. Der neue Code wird mit dem Rest deployt, aber kein Link führt dorthin, solange er nicht fertig ist; angebunden wird er zuletzt (Continuous Delivery, S. 348). Wo das nicht geht, bleibt der Feature-Toggle, ein Schalter in der Konfiguration, den wir im Artikel über Feature Flags behandeln.
Der Code ist lange vor der sichtbaren Funktion in Produktion. Das Release ist ein eigener Schritt.
Für unsere Kunden ermöglicht diese Trennung die Abnahme vor dem Release. In unserem Ansatz schreiben wir es so: „Sobald die Funktion freigegeben ist, machen wir die neue Version sichtbar. Der Code ist bereits über unsere automatisierte Deployment-Pipeline bereitgestellt und wartet nur noch auf die Aktivierung in Produktion.“ Bei der Freigabe binden wir zuletzt den Link zur Funktion an oder schalten ihren Feature-Toggle um.
Wenn eine Änderung etwas kaputt macht: in zehn Minuten beheben oder zurücknehmen
Kleine Schritte beseitigen Fehler nicht. Sie machen sie klein und schnell sichtbar. Dafür muss das Feedback schnell kommen.
Farley nennt drei Richtwerte, die er als seine Faustregeln vorstellt (Continuous Delivery Pipelines, S. 121):
die Tests der Commit-Stage laufen in weniger als 5 Minuten;
schlägt ein Test fehl, nimmt man sich etwa 10 Minuten, um einen Fix zu finden und zu committen oder die Änderung zurückzunehmen;
die Akzeptanztests und alle anderen Prüfungen der Pipeline laufen in weniger als einer Stunde, sodass man am selben Tag mehrere Gelegenheiten hat, ein Problem zu finden und zu beheben.
Warum zurücknehmen statt suchen? Ist das Problem nicht verstanden oder dauert die Behebung zu lange, nimmt man die Änderung zurück. Das verschafft Zeit zum Nachdenken, und die Pipeline bleibt für die anderen frei (S. 56).
Ist die Änderung klein, betrifft das Zurücknehmen nur sie. Die Historie bleibt lesbar:
$ git log --oneline -6
9c41e2a Revert "Rabatt auf den Bruttobetrag berechnen"
7d0f3b1 Rabatt auf den Bruttobetrag berechnen
5a8e6c4 Aufschlüsselung des Rabatts auf der Rechnung anzeigen
3b27d90 Rabatt über dem Bestellbetrag ablehnen
1f9a5e7 Rabattfeld im Formular hinzufügen, noch nicht angebunden
0c62b18 Eingegebenen Rabatt in der Bestellung speichern
Fiktive Historie, für diesen Artikel geschrieben.
Die Pipeline, die dieses Tempo möglich macht, und die Regel, die alles anhält, wenn sie rot ist, beschreiben wir im Artikel über Trunk-Based Development.
Was die DORA-Metriken messen und was sie über kleine Batches sagen
Das Forschungsprogramm DORA misst die Leistung der Softwareauslieferung mit fünf Metriken in zwei Gruppen („DORA’s software delivery performance metrics“).
Durchsatz:
die Durchlaufzeit einer Änderung (Change Lead Time), also die Zeit, die eine Änderung vom Commit in der Versionsverwaltung bis zum Deployment in Produktion braucht;
die Deployment-Häufigkeit;
die Wiederherstellungszeit nach einem fehlgeschlagenen Deployment.
Instabilität:
die Change Failure Rate, der Anteil der Deployments, die ein sofortiges Eingreifen erfordern;
die Deployment Rework Rate, der Anteil ungeplanter Deployments, die wegen eines Vorfalls in Produktion nötig werden.
DORA schreibt, dass Tempo und Stabilität sich nicht ausschließen: Bei den meisten Teams korrelieren diese Metriken.
Das Buch Accelerate (2018) von Nicole Forsgren, Jez Humble und Gene Kim fasst vier Jahre „State of DevOps“-Umfragen zusammen, von 2014 bis 2017: mehr als 23.000 Antworten aus mehr als 2.000 Organisationen. Nicole Forsgren hat diese Umfragen geleitet. In der Umfrage von 2017 deployten die leistungsstärksten Teams im Vergleich zu den leistungsschwächsten 46-mal häufiger. Ihre Durchlaufzeit vom Commit bis zum Deployment war 440-mal kürzer. Nach einem Ausfall stellten sie den Betrieb 170-mal schneller wieder her. Ihre Änderungen schlugen fünfmal seltener fehl (Accelerate, 2018, Kapitel 1). Über mehrere Umfragejahre hatten ihre Organisationen eine doppelt so hohe Chance, ihre Ziele bei Rentabilität, Marktanteil und Produktivität zu übertreffen (Kapitel 2).
Farley zitiert weitere Zahlen zu Continuous Delivery aus den „State of DevOps“-Berichten von 2014 und 2017: 50 % weniger fehlgeschlagene Änderungen, 44 % mehr Zeit für neue Funktionen und 21 % weniger Zeit für ungeplante Arbeit und Nacharbeit (Continuous Delivery Pipelines, S. 4).
Kleine Batches wirken auf beide Gruppen. Laut DORA verkürzt die Arbeit in kleinen Batches die Zeit, bis Feedback zu Änderungen vorliegt, was die Analyse und Behebung von Problemen erleichtert („Working in small batches“). Der Bericht von 2024 betont es noch einmal: Die Daten von DORA zeigen seit Jahren, dass größere Änderungen langsamer sind und häufiger Instabilität verursachen (Accelerate State of DevOps 2024, S. 40).
Das sind Korrelationen aus Umfragen, keine Kausalbeweise. Nach heutigem Stand weisen sie in den zitierten Studien in dieselbe Richtung wie der oben beschriebene Mechanismus.
Wie wir arbeiten
Wir entwickeln in kleinen Änderungen, die kontinuierlich deployt und nach der Abnahme durch unsere Kunden released werden.
Bei der Entwicklung individueller Software arbeiten wir mit einem festen Budget, das am Ende jedes Monats für die geleistete Arbeit abgerechnet wird. Ihre Anwendung ist innerhalb eines Monats nutzbar, mit einigen wesentlichen Funktionen: Ihre Nutzer arbeiten sofort damit, und wie sie sie nutzen, bestimmt, welche Funktionen als Nächstes entwickelt werden. Sobald eine Funktion abgenommen und released ist, wird sie daran gemessen, wie Ihre Nutzer reagieren, und wir entscheiden sofort mit Ihnen über die nächsten, so lange Sie es wünschen. Eine Anwendung ist nie fertig.
Und damit das, was im letzten Monat funktioniert hat, auch in diesem Monat noch funktioniert, gilt unsere Null-Regressions-Garantie: Jede Regression wird behoben und durch einen automatisierten Test abgesichert, damit sie nicht wiederkehrt, ohne Aufpreis.
Weiterlesen
In unserem Leitfaden finden Sie die Fragen, die Sie stellen sollten, bevor Sie ein Angebot für die Entwicklung Ihres individuellen Tools unterschreiben.
Möchten Sie eine Software entwickeln lassen, und soll sie so gebaut werden? Sprechen wir darüber?
Quellen
Die Übersetzungen englischer Zitate stammen von uns.
Jez Humble und David Farley, Continuous Delivery, Addison-Wesley, 2010, S. 266, 267 und 348.
Dave Farley, Continuous Delivery Pipelines, 2021, S. 4, 6, 54 bis 56, 110, 111 und 121.
Was ist ein Feature Flag? Vier Arten von Toggles, was Sie versuchen sollten, bevor Sie einen hinzufügen, und sieben Anti-Patterns, durch die nie getesteter Code läuft.
App entwickeln lassen: Mit welchem Budget rechnen? Der Betrag allein reicht nicht: Setzen Sie auf ein Ziel statt auf eine Liste, mit Nutzern ab dem ersten Monat.
Prädiktiver oder adaptiver Ansatz? Der eigentliche Unterschied liegt nicht zwischen V-Modell und agilem Vorgehen, sondern zwischen Vorhersagen und Anpassen. Was das für Software bedeutet.