Feature flags: feature toggles goed gebruiken, en zeven anti-patterns om te vermijden
Wat is een feature flag? Vier typen toggles, wat u probeert voordat u er een toevoegt, en zeven anti-patterns waardoor code draait die nooit is getest.
11 min leestijd
Sébastien Nobour
Oprichter van DEVEDANOS
Continuous Delivery, Continuous Deployment: aan definities geen gebrek. Ze vertellen wat de twee praktijken zijn. Ze vertellen zelden waarom ze werken, oftewel waarom een kleine wijziging die vaak in productie gaat minder riskant is dan een grote wijziging die zelden in productie gaat.
Dit artikel gaat uit van die vraag en zet op een rij wat de geciteerde bronnen daar in 2026 op antwoorden. Het is bedoeld voor technisch leidinggevenden en developers die het mechanisme willen begrijpen, niet alleen de woorden.
Bij Continuous Delivery staat de software op elk moment klaar om naar productie te gaan. Bij Continuous Deployment gaat ze er automatisch heen, zodra de pipeline groen is.
In beide gevallen doorloopt elke wijziging dezelfde deployment pipeline: build, geautomatiseerde tests, controles. Jez Humble en Dave Farley, de auteurs van het boek dat Continuous Delivery heeft gedefinieerd, beschrijven Continuous Deployment als diezelfde pipeline waarvan de laatste stap, de deployment naar productie, automatisch wordt (Continuous Delivery, 2010, p. 266). Farley vat het elders samen in één formule: Continuous Deployment is “de beslissing om te releasen automatiseren”.
Bij Continuous Delivery blijft die beslissing bij een mens. De software staat klaar; iemand kiest het moment. De twee auteurs voegen er een regel aan toe: ook als je goede redenen hebt om niet elke wijziging te releasen, werk je alsof je dat wel gaat doen (p. 267).
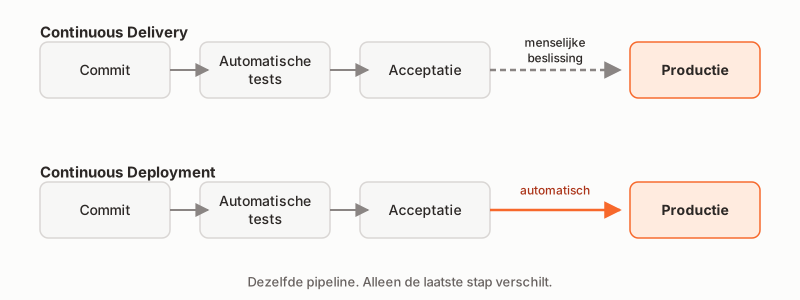
De rest van dit artikel geldt voor beide praktijken. Wat ze gemeen hebben, telt zwaarder dan wat ze onderscheidt: kleine, frequente wijzigingen.
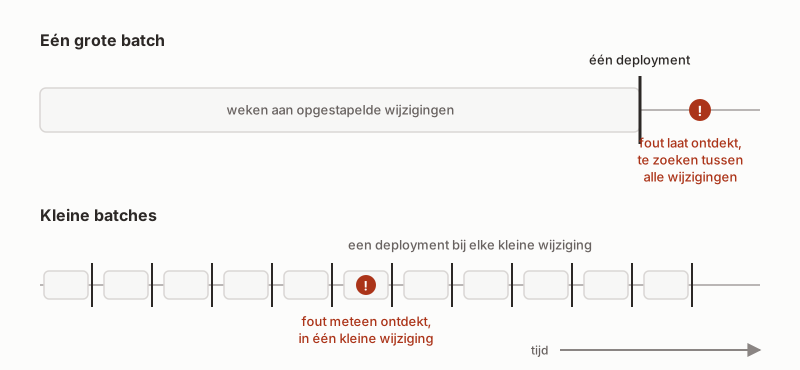
Een kleine wijziging raakt weinig code. Faalt er direct daarna een test, dan zit de oorzaak in die wijziging. De developer die haar net heeft geschreven, heeft haar nog vers in het geheugen. Hij lost het meteen op, of hij draait zijn commit terug.
Een grote wijziging raakt veel code. Duikt er een fout op, dan zit die verstopt tussen alle aanpassingen die erin zitten. De oorzaak zoeken kost tijd. Alles terugdraaien haalt ook weg wat wel werkte.
Farley maakt er een grondbeginsel van Continuous Delivery van. Kleine, eenvoudige, frequente wijzigingen zijn minder riskant dan grote, ingewikkelde en zeldzame. Omdat ze eenvoudiger zijn, zijn ze makkelijker te begrijpen en terug te draaien. Kleinere stappen betekenen kleinere fouten en snellere feedback (Continuous Delivery Pipelines, 2021, p. 54).
Humble en Farley passen dezelfde redenering toe op releases. Hoe vaker je released, hoe kleiner het risico van elke release, omdat er tussen twee releases minder verandert. Release je elke wijziging, dan beperkt het risico zich tot dat van die ene wijziging (Continuous Delivery, p. 267).
De omgekeerde reflex komt veel voor: meer controles toevoegen. Goedkeuring door een commissie, nog een handtekening vóór elke release. Farley beschrijft wat er dan gebeurt. Releases worden zeldzamer, dus groter en complexer, dus is de kans op fouten groter (Continuous Delivery Pipelines, p. 110). Hij citeert het rapport van DORA, het onderzoeksprogramma van Google Cloud naar hoe software wordt ontwikkeld en in productie gaat: goedkeuringen door een externe instantie hangen negatief samen met de doorlooptijd, de deploymentfrequentie en de hersteltijd, en hangen niet samen met het percentage mislukte wijzigingen (p. 111).
Een kleine wijziging is geen functionaliteit. Een functionaliteit bouw je op in meerdere commits, die elk getest zijn en klaarstaan voor productie. Farley zegt het zo: bouw functionaliteiten op uit meerdere commits, zodat het product stap voor stap evolueert, met frequente feedback van gebruikers. Als een functionaliteit te groot is, knip haar dan op in kleinere stukken (Continuous Delivery Pipelines, p. 55).
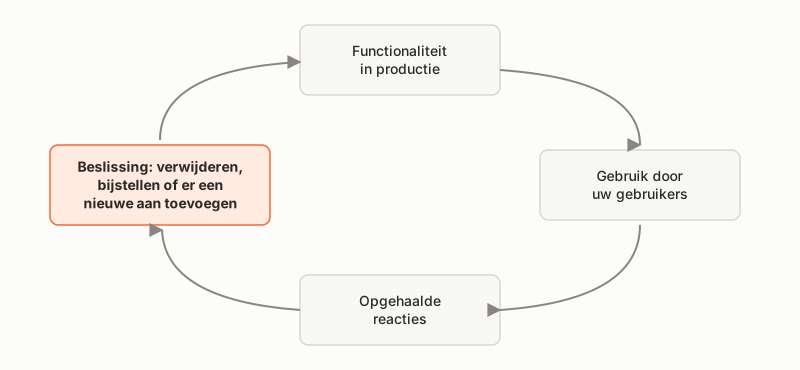
Voor hem is een wijziging pas af als ze in handen is van de gebruikers (p. 6). Daar betalen kleine stappen zich uit. Elke functionaliteit komt snel bij de mensen die haar gebruiken, en hun gebruik laat zien of ze nuttig was.
Dat is de cyclus die we beschrijven in onze aanpak: “Zodra een functionaliteit live staat, vertellen de reacties die wij bij uw gebruikers ophalen ons wat de volgende stap is: deze verwijderen, bijstellen of er een nieuwe aan toevoegen.”
De vraag is dan wat we opknippen, en in welke volgorde. We knippen niet op volgens een geschatte duur. We stellen één vraag: wat is nu het nuttigste om te doen? Een tijdsschatting blijft een aanname; waarom, leggen we uit in het artikel over softwareprojecten die hun budget overschrijden.
Een functionaliteit die in meerdere commits wordt gebouwd, gaat door tussenstadia. Een half afgewerkt scherm mag niet bij de gebruikers verschijnen. Moet je dan wachten tot ze af is om te deployen? Nee. Je hoeft alleen twee handelingen uit elkaar te halen.
Farley maakt dat onderscheid in een artikel uit 2020, “Are we ‘Deploying’, ‘Releasing’ or ‘Delivering’?”:
In de dagelijkse praktijk zegt men vaak “in productie zetten” voor allebei. Bij DEVEDANOS gebruiken we “releasen” alleen voor de tweede handeling. We deployen de code continu, en releasen de functionaliteit zodra ze is goedgekeurd.
Farley wijst erop dat je wijzigingen kunt deployen die nog niet klaar zijn voor gebruik. Hij leidt er een werkregel uit af: elke commit moet veilig zijn, getest en klaar om naar productie te deployen, ook als de functionaliteit waaraan hij bijdraagt nog niet klaar is (Continuous Delivery Pipelines, p. 55).
Hoe blijft gedeployde code onzichtbaar? Humble en Farley beschrijven één oplossing. De nieuwe code wordt samen met de rest gedeployd, maar geen enkele link leidt ernaartoe zolang ze niet af is; je sluit haar als laatste aan (Continuous Delivery, p. 348). Kan dat niet, dan is er nog de feature toggle, een schakelaar in de configuratie, die we behandelen in het artikel over feature flags.
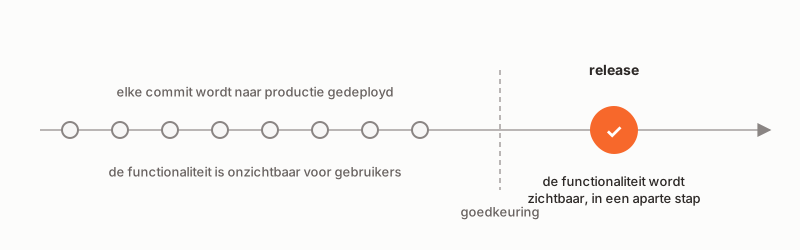
Voor onze klanten maakt deze scheiding het mogelijk een functionaliteit goed te keuren voordat ze wordt gereleased. In onze aanpak schrijven we het zo: “Zodra de functionaliteit is goedgekeurd, maken wij de nieuwe versie zichtbaar. De code is al uitgerold via onze geautomatiseerde deployment-pipeline en wacht op dat groene licht om geactiveerd te worden in productie.” Bij dat groene licht voegen we als laatste de link naar de functionaliteit toe, of zetten we haar feature toggle om.
Werken in kleine stappen haalt fouten niet weg. Het maakt ze klein, en snel zichtbaar. Maar de feedback moet ook snel komen.
Farley geeft drie ordegroottes, die hij presenteert als zijn vuistregels (Continuous Delivery Pipelines, p. 121):
Waarom terugdraaien in plaats van zoeken? Begrijp je het probleem niet, of kost het oplossen te lang, dan draai je de wijziging terug. Zo heb je tijd om na te denken, en blijft de pipeline vrij voor de anderen (p. 56).
Is de wijziging klein, dan haalt het terugdraaien alleen die wijziging weg. De historie blijft leesbaar:
$ git log --oneline -6
9c41e2a Revert "Korting berekenen over het totaal inclusief btw"
7d0f3b1 Korting berekenen over het totaal inclusief btw
5a8e6c4 Opbouw van de korting tonen op de factuur
3b27d90 Korting hoger dan het orderbedrag weigeren
1f9a5e7 Kortingsveld toevoegen aan het formulier, nog niet aangesloten
0c62b18 Ingevoerde korting opslaan bij de order
Fictieve historie, geschreven voor dit artikel.
De pipeline die dit tempo mogelijk maakt, en de regel die alles stillegt als ze rood is, beschrijven we in het artikel over trunk-based development.
Het onderzoeksprogramma DORA volgt de prestaties van softwarelevering met vijf metrics, verdeeld over twee groepen (“DORA’s software delivery performance metrics”).
Doorvoer:
Instabiliteit:
DORA schrijft dat snelheid en stabiliteit niet tegen elkaar worden uitgeruild: bij de meeste teams hangen deze metrics met elkaar samen.
Het boek Accelerate (2018), van Nicole Forsgren, Jez Humble en Gene Kim, bundelt vier jaar “State of DevOps”-enquêtes, van 2014 tot en met 2017: meer dan 23.000 antwoorden van meer dan 2.000 organisaties. Nicole Forsgren leidde die enquêtes. In de enquête van 2017 deployden de best presterende teams, vergeleken met de slechtst presterende, 46 keer zo vaak. Hun doorlooptijd van commit tot deployment was 440 keer zo kort. Na een storing herstelden ze de dienstverlening 170 keer zo snel. Hun wijzigingen mislukten vijf keer minder vaak (Accelerate, 2018, hoofdstuk 1). Over meerdere enquêtejaren hadden hun organisaties twee keer zoveel kans om hun doelen voor winstgevendheid, marktaandeel en productiviteit te overtreffen (hoofdstuk 2).
Farley haalt nog andere cijfers over Continuous Delivery aan uit de “State of DevOps”-rapporten van 2014 en 2017: 50 % minder mislukte wijzigingen, 44 % meer tijd voor nieuwe functionaliteiten en 21 % minder tijd voor ongepland werk en herstelwerk (Continuous Delivery Pipelines, p. 4).
Kleine batches raken beide groepen. Volgens DORA verkort werken in kleine batches de tijd die nodig is om feedback op wijzigingen te krijgen, waardoor problemen makkelijker te analyseren en op te lossen zijn (“Working in small batches”). Het rapport van 2024 herhaalt het: de data van DORA laten al jaren zien dat grotere wijzigingen trager zijn en vaker instabiliteit veroorzaken (Accelerate State of DevOps 2024, p. 40).
Het gaat om correlaties uit enquêtes, geen bewijs van oorzaak en gevolg. Tot op heden wijzen ze, in de geciteerde studies, in dezelfde richting als het mechanisme hierboven.
We ontwikkelen in kleine wijzigingen, die continu worden gedeployd en gereleased zodra onze klanten ze hebben goedgekeurd.
Voor de ontwikkeling van software op maat werken we voor een vast budget, aan het einde van elke maand gefactureerd voor het geleverde werk. Uw applicatie is binnen een maand bruikbaar, met een paar essentiële functionaliteiten: uw gebruikers gaan er meteen mee aan de slag, en hoe ze ermee werken, bepaalt welke functionaliteiten we daarna ontwikkelen. Zodra een functionaliteit is goedgekeurd en gereleased, wordt die beoordeeld op de reactie van uw gebruikers, en beslissen we meteen met u over de volgende, zolang u dat wenst. Een applicatie is nooit af.
En om ervoor te zorgen dat wat vorige maand werkte, ook deze maand werkt, hanteren we een nulregressiegarantie: elke regressie wordt verholpen en afgedekt door een geautomatiseerde test, zodat ze niet terugkomt, zonder meerkosten.
In onze gids vindt u de vragen die u moet stellen voordat u een offerte voor de ontwikkeling van uw maatwerktool tekent.
Wilt u software laten ontwikkelen, en wilt u dat die zo gebouwd wordt? Zullen we kennismaken?
De vertalingen van Engelse citaten zijn van ons.
Wat is een feature flag? Vier typen toggles, wat u probeert voordat u er een toevoegt, en zeven anti-patterns waardoor code draait die nooit is getest.
Hoeveel budget hebt u nodig om een app te laten maken? Het bedrag alleen zegt te weinig: stuur op een doel in plaats van een lijst, met gebruikers vanaf de eerste maand.
Voorspellende of adaptieve aanpak? Het echte verschil zit niet tussen de watervalmethode en agile, maar tussen voorspellen en je aanpassen. Wat dat betekent voor software.