Feature flags : bien utiliser les feature toggles, et sept anti-patterns à éviter
Feature flag, c'est quoi ? Quatre types de toggles, ce qu'il faut essayer avant d'en ajouter un, et sept anti-patterns qui font tourner du code jamais testé.
11 min de lecture
Sébastien Nobour
Fondateur de DEVEDANOS
Livraison continue, déploiement continu : les définitions ne manquent pas. Elles disent ce que sont ces deux pratiques. Elles disent rarement pourquoi elles fonctionnent, c’est-à-dire pourquoi un petit changement mis en production souvent présente moins de risque qu’un gros changement mis en production rarement.
Cet article part de cette question. Il s’adresse aux responsables techniques et aux développeurs qui veulent comprendre le mécanisme, pas seulement le vocabulaire.
La livraison continue garde le logiciel prêt à partir en production à tout moment. Le déploiement continu l’y envoie automatiquement, dès que le pipeline est vert.
Dans les deux cas, chaque modification traverse le même pipeline de déploiement : compilation, tests automatisés, vérifications. Jez Humble et Dave Farley, auteurs du livre qui a défini la livraison continue, décrivent le déploiement continu comme ce même pipeline dont on rend automatique la dernière étape, le déploiement en production (Continuous Delivery, 2010, p. 266). Farley le résume ailleurs en une formule : le déploiement continu, c’est « automatiser la décision de mettre en production ».
En livraison continue, cette décision reste humaine. Le logiciel est prêt ; quelqu’un choisit le moment. Les deux auteurs ajoutent une consigne : même quand on a de bonnes raisons de ne pas mettre en production chaque changement, il faut travailler comme si on allait le faire (p. 267).
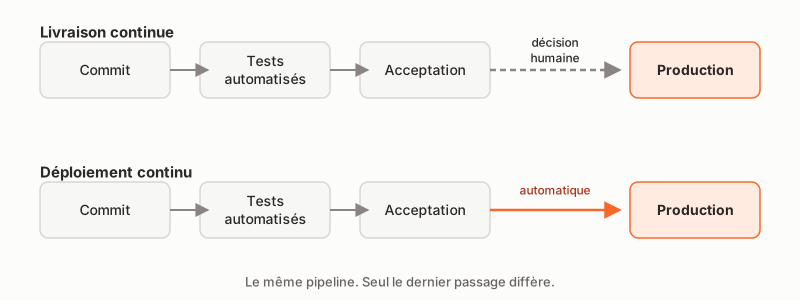
Le reste de l’article vaut pour les deux pratiques. Leur point commun compte plus que leur différence : des changements petits et fréquents.
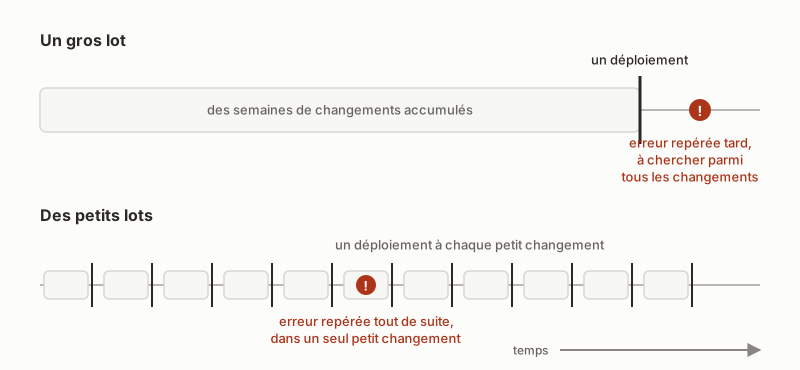
Un petit changement touche peu de choses. Si un test échoue juste après, la cause se trouve dans ce changement. Le développeur qui vient de l’écrire l’a encore en tête. Il corrige tout de suite, ou il annule son commit.
Un gros changement touche beaucoup de choses. Quand une erreur apparaît, elle se cache parmi toutes les modifications qu’il contient. Chercher la cause prend du temps. Annuler le tout retire aussi ce qui fonctionnait.
Farley en fait un principe fondateur de la livraison continue. De petits changements simples et fréquents sont moins risqués que des changements gros, compliqués et rares. Plus simples, ils se comprennent et s’annulent plus facilement. Des pas plus petits produisent des erreurs plus petites et un retour plus rapide (Continuous Delivery Pipelines, 2021, p. 54).
Humble et Farley appliquent le même raisonnement aux mises en production. Plus elles sont fréquentes, moins chacune est risquée, parce que la quantité de changement entre deux mises en production diminue. Si l’on met en production chaque changement, le risque se limite à celui de ce seul changement (Continuous Delivery, p. 267).
Le réflexe inverse est courant : ajouter des contrôles. Une validation par un comité, une signature de plus avant chaque mise en production. Farley décrit ce qui suit. Les mises en production deviennent plus rares, donc plus grosses et plus complexes, donc plus susceptibles d’introduire des erreurs (Continuous Delivery Pipelines, p. 110). Il cite le rapport de DORA, le programme de recherche de Google Cloud sur le développement et la mise en production des logiciels : les approbations par un organe externe sont corrélées négativement avec le délai de livraison, la fréquence de déploiement et le temps de rétablissement, et ne sont pas corrélées avec le taux d’échec des changements (p. 111).
Un petit changement n’est pas une fonctionnalité. Une fonctionnalité se construit en plusieurs commits, chacun testé et prêt à partir en production. Farley le formule ainsi : construire les fonctionnalités à partir de plusieurs commits, pour faire évoluer le produit progressivement, avec des retours fréquents des utilisateurs. Et si une fonctionnalité est trop grosse, la découper en morceaux plus petits (Continuous Delivery Pipelines, p. 55).
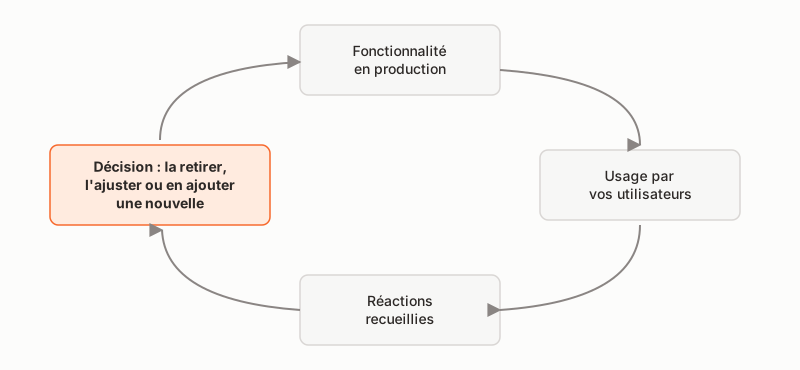
Pour lui, un changement n’est terminé que lorsqu’il est entre les mains de ses utilisateurs (p. 6). C’est là que les petits pas rapportent. Chaque fonctionnalité rejoint vite les personnes qui s’en servent, et leur usage montre si elle était utile.
C’est la boucle que nous décrivons dans notre approche : « Dès qu’une fonctionnalité est mise en ligne, les réactions que nous recueillons auprès de vos utilisateurs nous disent ce qu’il faut faire ensuite : la retirer, l’ajuster ou en ajouter une nouvelle. »
Reste à choisir quoi découper, et dans quel ordre. Nous ne découpons pas selon une durée estimée. Nous posons une seule question : quelle est la chose la plus utile à faire maintenant ? Une estimation de durée reste une supposition ; nous expliquons pourquoi dans l’article sur les projets logiciels qui dépassent leur budget.
Une fonctionnalité construite en plusieurs commits passe par des états intermédiaires. Un écran à moitié fait ne doit pas apparaître aux utilisateurs. Faut-il attendre qu’elle soit finie pour déployer ? Non. Il suffit de séparer deux gestes.
Farley les distingue dans un article de 2020, « Are we Deploying, Releasing or Delivering? » :
En français, on dit souvent « mettre en production » pour les deux. Chez DEVEDANOS, nous réservons l’expression au second geste. Nous déployons le code en continu, puis nous mettons la fonctionnalité en production une fois qu’elle est recettée.
Farley précise qu’on peut déployer des changements qui ne sont pas encore prêts à être utilisés. Il en tire une règle de travail : chaque commit doit être sûr, testé et prêt à être déployé en production, même quand la fonctionnalité à laquelle il contribue n’est pas encore prête (Continuous Delivery Pipelines, p. 55).
Comment un code déployé reste-t-il invisible ? Humble et Farley décrivent le moyen le plus simple. Le nouveau code est déployé avec le reste, mais aucun lien n’y mène tant qu’il n’est pas fini ; on le relie en dernier (Continuous Delivery, p. 348). Quand ce n’est pas possible, il reste le feature toggle, un interrupteur dans la configuration, que nous traitons dans l’article sur les feature toggles.
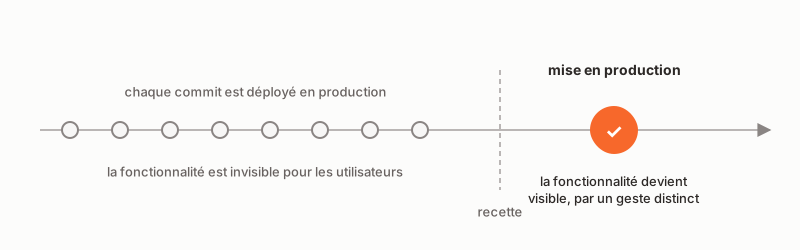
Pour nos clients, cette séparation rend possible la recette avant la mise en production. Nous l’écrivons ainsi dans notre approche : « Dès que la fonctionnalité est recettée, nous rendons la nouvelle version visible. Le code est déjà déployé via notre pipeline de déploiement automatisé et attend ce feu vert pour être activé en production. » Au feu vert, nous ajoutons en dernier le lien vers la fonctionnalité, ou nous basculons son feature toggle.
Travailler par petits pas ne supprime pas les erreurs. Cela les rend petites, et vite visibles. Encore faut-il que le retour arrive vite.
Farley donne trois ordres de grandeur, qu’il présente comme ses règles empiriques (Continuous Delivery Pipelines, p. 121) :
Pourquoi annuler plutôt que chercher ? Si le problème n’est pas compris, ou s’il prend trop de temps à corriger, on annule le changement. Cela laisse le temps de réfléchir, et le pipeline reste libre pour les autres (p. 56).
Quand le changement est petit, l’annulation ne retire que lui. L’historique reste lisible :
$ git log --oneline -6
9c41e2a Revert "Calculer la remise sur le total TTC"
7d0f3b1 Calculer la remise sur le total TTC
5a8e6c4 Afficher le détail de la remise sur la facture
3b27d90 Refuser une remise supérieure au montant de la commande
1f9a5e7 Ajouter le champ remise au formulaire, non relié
0c62b18 Enregistrer la remise saisie sur la commande
Historique fictif, écrit pour cet article.
Le pipeline qui rend ce rythme possible, et la règle qui arrête tout quand il est rouge, sont décrits dans l’article sur le trunk-based development.
Le programme de recherche DORA suit la performance de livraison logicielle avec cinq métriques, réparties en deux groupes (« DORA’s software delivery performance metrics »).
Le débit :
L’instabilité :
DORA écrit que vitesse et stabilité ne s’échangent pas l’une contre l’autre : pour la plupart des équipes, ces métriques sont corrélées.
Le livre Accelerate (2018), écrit par Nicole Forsgren, Jez Humble et Gene Kim, rassemble quatre années d’enquêtes « State of DevOps », de 2014 à 2017 : plus de 23 000 réponses venues de plus de 2 000 organisations. Nicole Forsgren a dirigé ces enquêtes. Dans l’enquête 2017, comparées aux équipes les moins performantes, les plus performantes déployaient 46 fois plus souvent. Leur délai entre le commit et le déploiement était 440 fois plus court. Après une panne, elles rétablissaient le service 170 fois plus vite. Leurs changements échouaient cinq fois moins souvent (Accelerate, 2018, chapitre 1). Sur plusieurs années d’enquête, leurs organisations avaient deux fois plus de chances de dépasser leurs objectifs de rentabilité, de part de marché et de productivité (chapitre 2).
Farley reprend d’autres chiffres des rapports « State of DevOps » sur la livraison continue : 50 % d’échecs de changements en moins, 44 % de temps en plus consacré aux nouvelles fonctionnalités et 21 % de temps en moins passé sur le travail imprévu et les reprises (Continuous Delivery Pipelines, p. 4).
Les petits lots touchent les deux groupes. Selon DORA, travailler en petits lots réduit le temps nécessaire pour obtenir un retour sur les changements, ce qui facilite le diagnostic et la correction des problèmes (« Working in small batches »). Le rapport 2024 le rappelle : les données de DORA montrent depuis des années que les gros changements sont plus lents et plus souvent source d’instabilité (Accelerate State of DevOps 2024, p. 40).
Ce sont des corrélations, tirées d’enquêtes, pas des preuves de cause. Elles vont dans le même sens que le mécanisme décrit plus haut.
Nous développons par petits changements, déployés en continu, et mis en production après la recette de nos clients.
Pour le développement d’un logiciel sur mesure, nous travaillons pour un budget fixe, facturé chaque fin de mois pour le travail réalisé. Votre application est utilisable en un mois, en quelques fonctionnalités essentielles : vos utilisateurs s’en servent immédiatement, et c’est leur usage qui définit les fonctionnalités suivantes à développer. Une fois recettée et mise en production, chaque fonctionnalité est jugée sur la réaction de vos utilisateurs, et nous décidons aussitôt avec vous des suivantes, tant que vous le souhaitez. Une application n’est jamais finie.
Et pour que ce qui fonctionnait le mois dernier fonctionne encore ce mois-ci, nous appliquons une garantie zéro régression : chaque régression est corrigée et couverte par un test automatisé, pour qu’elle ne revienne pas, et sans surcoût.
Dans notre guide, vous trouverez les questions à poser avant de signer un devis pour le développement de votre outil sur mesure.
Vous avez un logiciel à faire développer, et vous voulez qu’il soit construit ainsi ? On en parle ?
Les citations traduites de l’anglais le sont par nous.
Feature flag, c'est quoi ? Quatre types de toggles, ce qu'il faut essayer avant d'en ajouter un, et sept anti-patterns qui font tourner du code jamais testé.
Quel budget pour créer une application ? Le montant ne suffit pas : visez un objectif plutôt qu'une liste, avec des utilisateurs dès le premier mois.
Approche prédictive ou adaptative ? La vraie différence n'est pas entre le cycle en V et l'agilité, mais entre prédire et s'adapter. Ce que cela change pour un logiciel.